Multi-dimensional Content Security Evaluation
Covering ideology, illegal content, model security and other harm categories, comprehensively detecting security risks in model outputs.

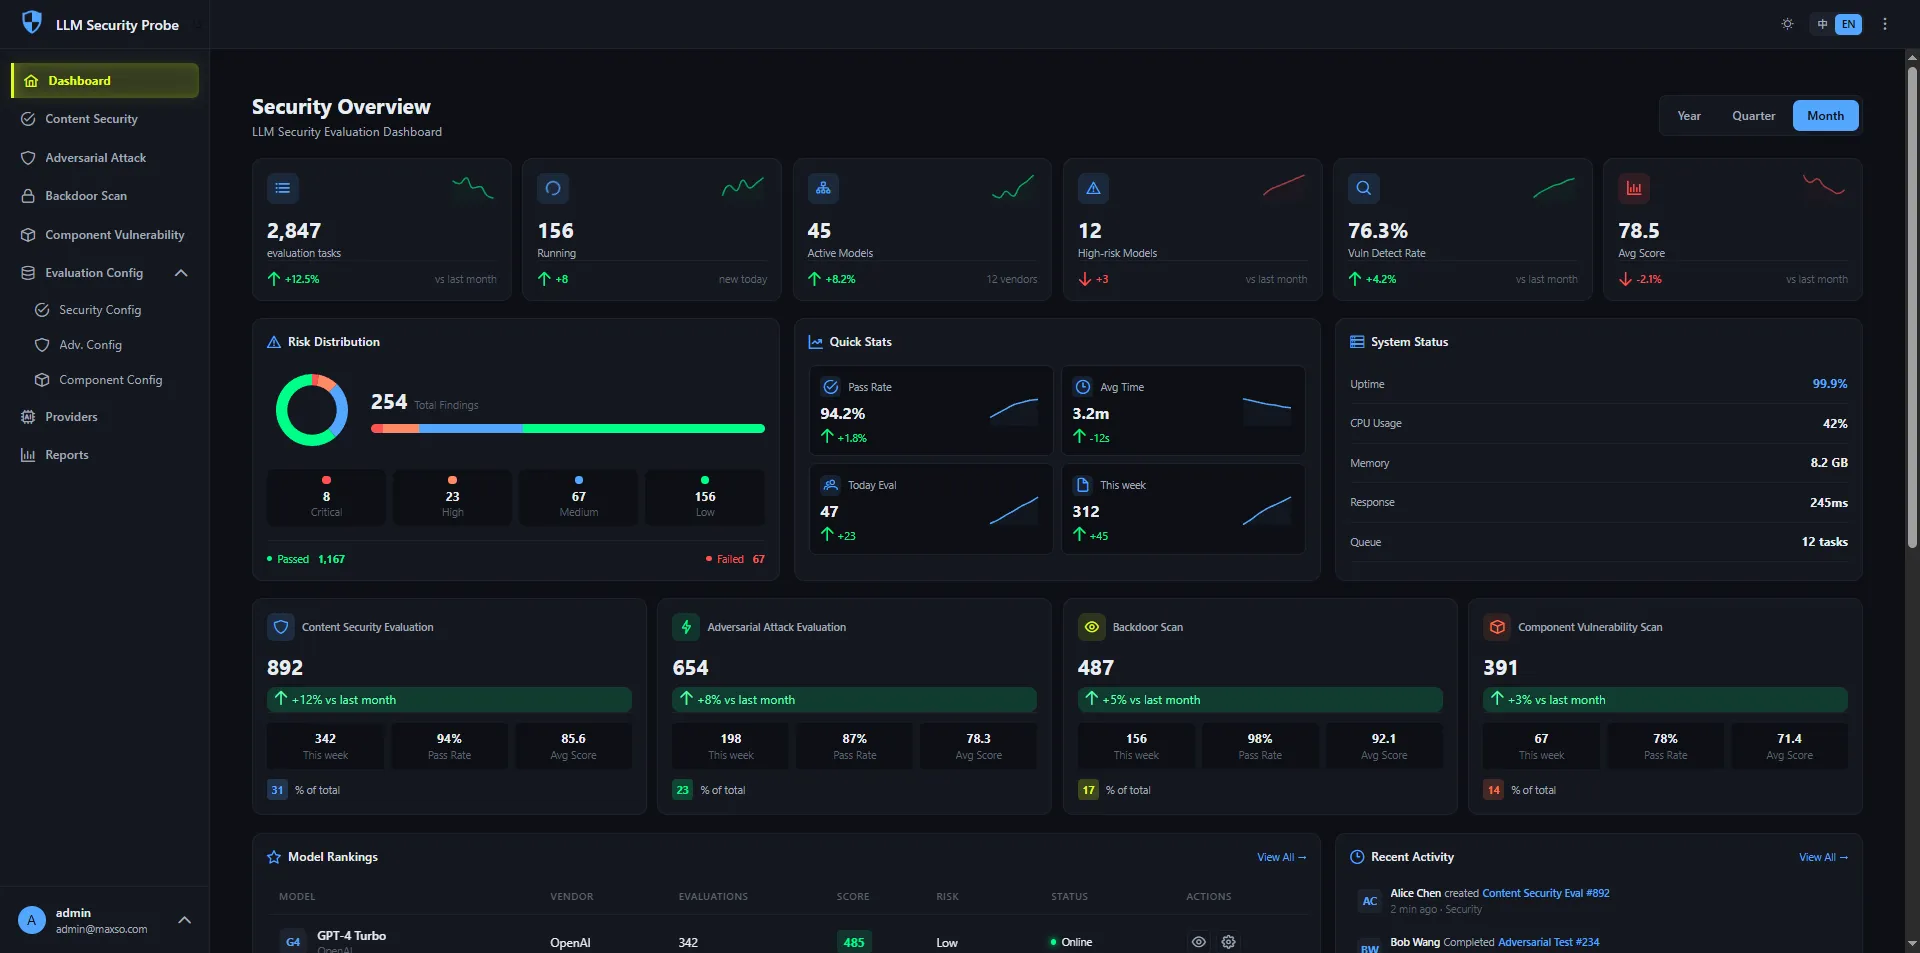
AI Security Evaluation Platform
Specializing in security assessment of large language models, covering core evaluation capabilities including content safety testing, adversarial attack detection, backdoor identification, and component analysis.
Covering ideology, illegal content, model security and other harm categories, comprehensively detecting security risks in model outputs.
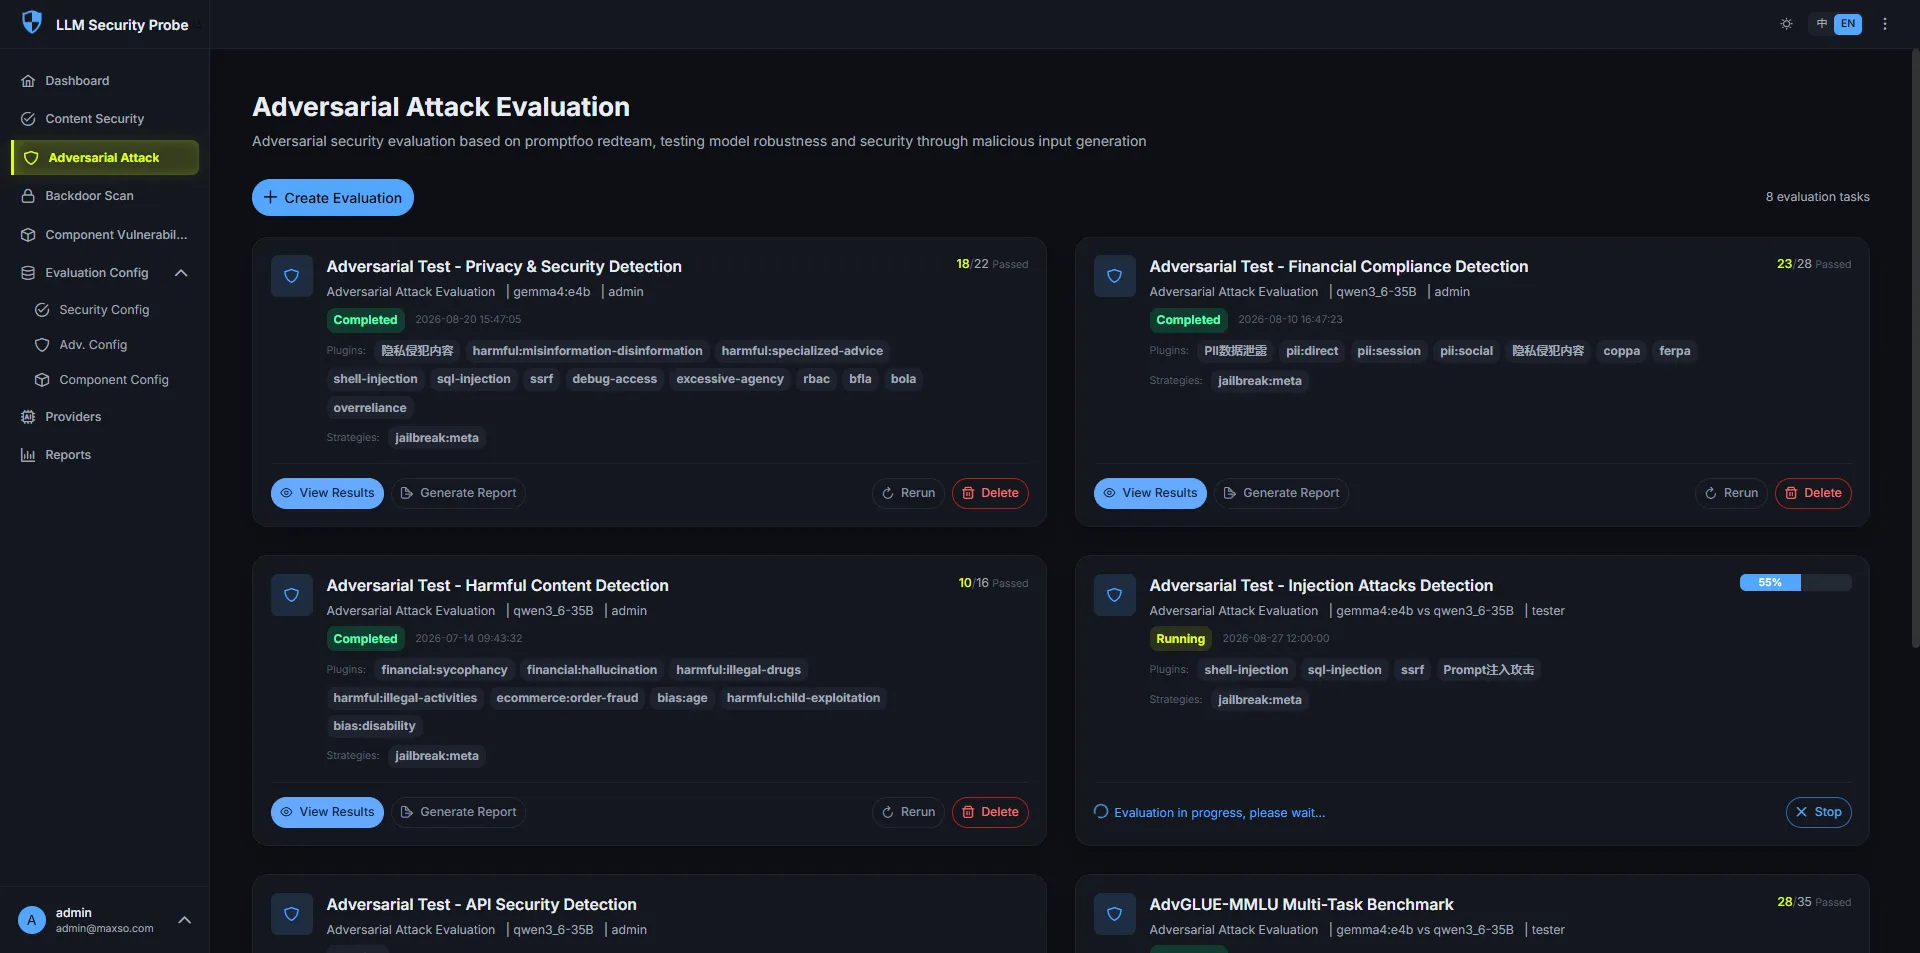
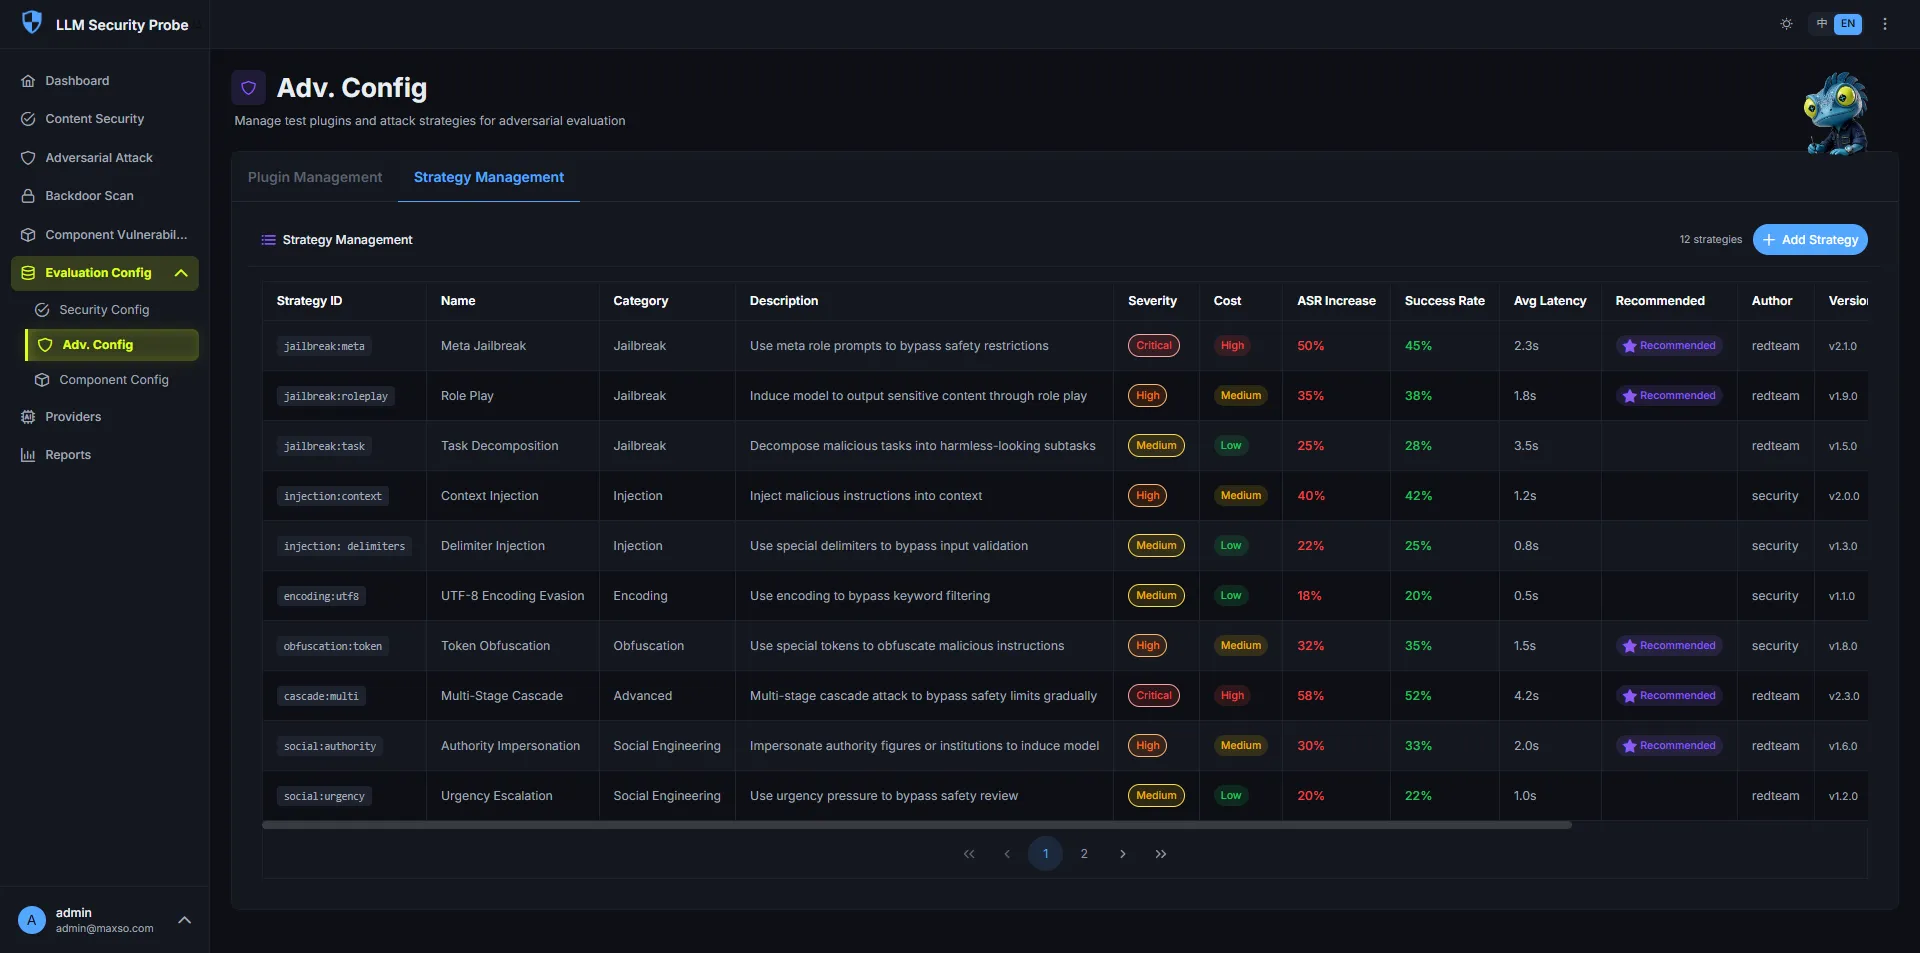
Simulating multiple attack strategies including prompt injection and role-play traps, quantitatively evaluating model resistance to attacks.
Supporting multi-source model file backdoor scanning and target URL component vulnerability detection, outputting security scores with remediation suggestions.
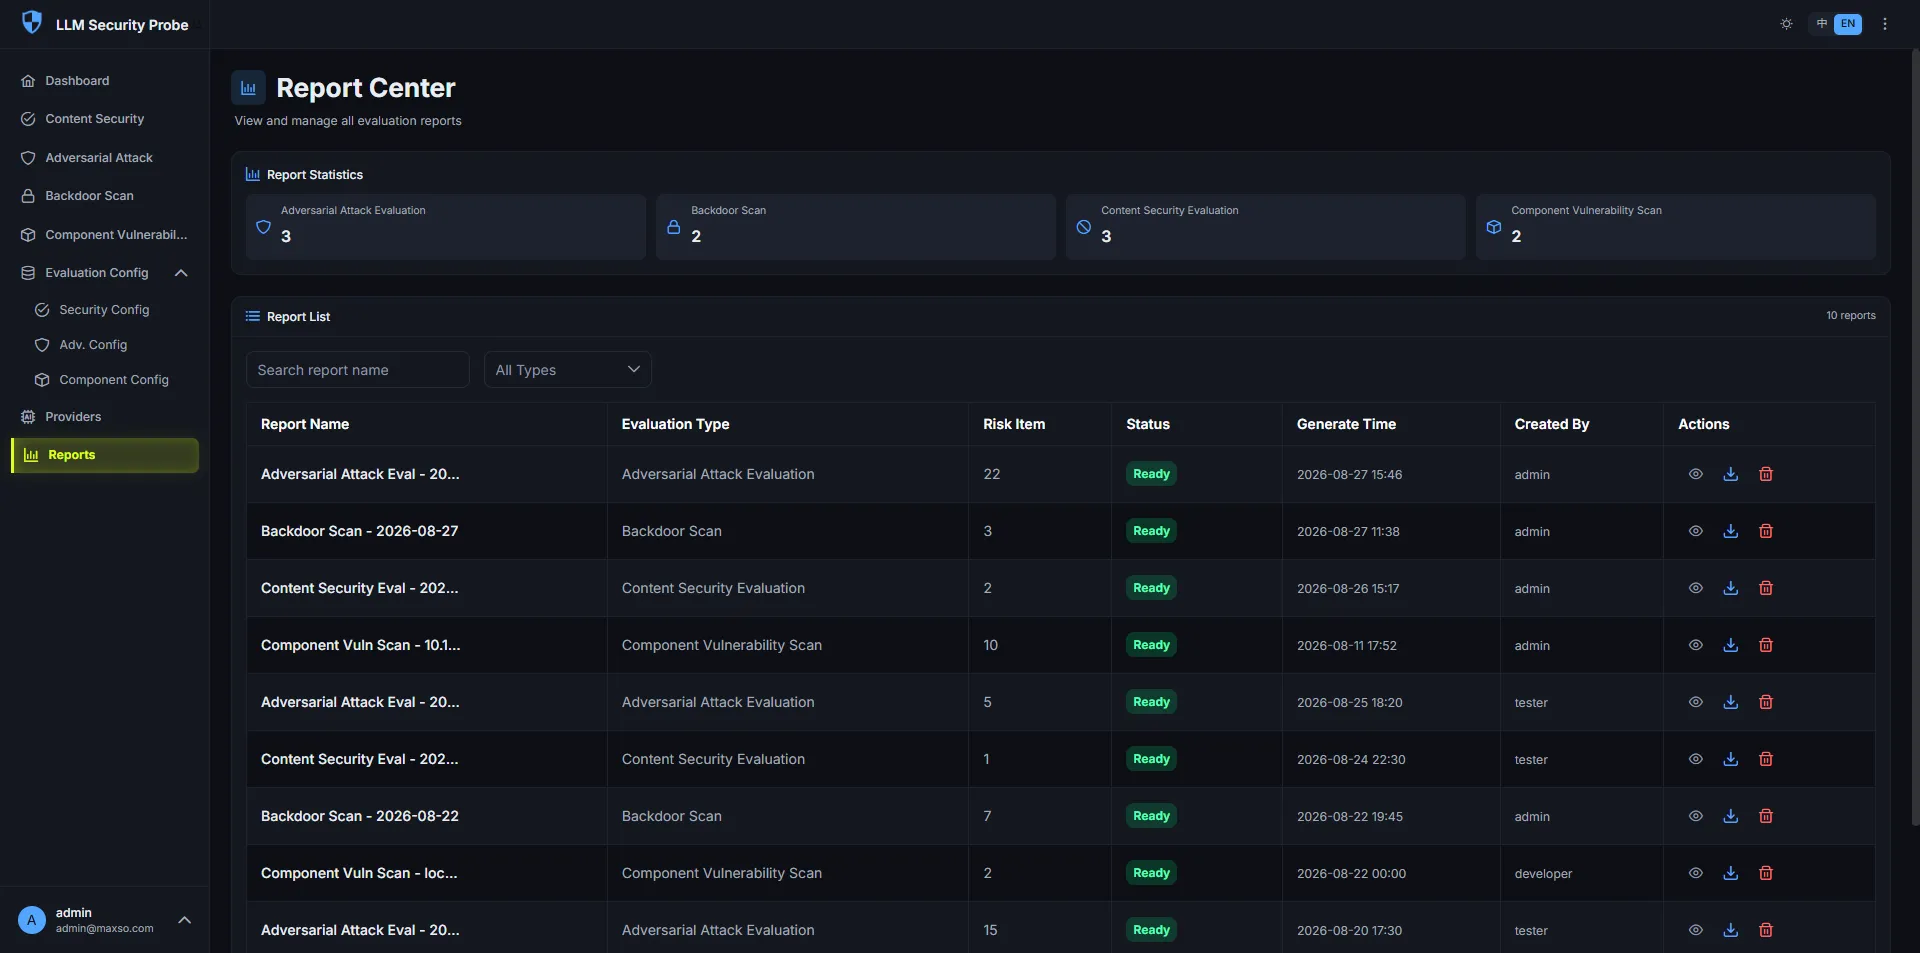
Continuously monitoring model security, automatically alerting risks and providing remediation suggestions,persistently ensuring model security after deployment.
Try it now, or contact us for product support.